





Bestehende APIs als MCP-Tools zu verpacken schien der richtige Ausgangspunkt zu sein. Das war es nicht. Agenten lesen keine Doku, verwalten keinen Zustand und komponieren keine granularen Endpunkte so, wie Entwickler:innen es tun. Das falsch zu machen, hat uns das meiste von dem gelehrt, was wir heute über das Bauen für Agenten wissen.
Anfang 2025 begann Webflow, für MCP zu bauen, bevor es ein klares Playbook für agentenfähige APIs gab. Wir kündigten unseren MCP-Server im April 2025 öffentlich an und nahmen anschließend am Cloudflare Demo Day im Mai 2025 teil, gemeinsam mit der ersten Welle von Remote-MCP-Servern.
Unser erster Ansatz war unkompliziert: bestehende APIs als MCP-Tools verpacken. Doch wir lernten schnell, dass für Entwickler:innen konzipierte APIs für Agenten nicht gut funktionieren. Developer-APIs setzen voraus, dass Menschen Doku lesen, recherchieren oder Antworten aus verschiedenen externen Quellen beziehen, granulare Endpunkte zusammensetzen, Zustand verwalten und Fehler manuell behandeln können. Agenten arbeiten mit weit weniger implizitem Kontext und verlassen sich stark auf die API-Oberfläche selbst, um Planung und Ausführung zu steuern und zu entscheiden, ob wiederholt, überarbeitet oder abgebrochen wird. Entwickler-APIs direkt an Agenten zu exponieren machte unsere frühen MCP-Tools also zu low-level und zu geschwätzig, sie erforderten oft viele Tool-Calls für einfache Aufgaben, während sie bei komplexeren Workflows kämpften. Das Ergebnis waren subtile Fehler, ineffiziente Laufzeiten und unzuverlässige Aufgabenerledigung.
Im darauffolgenden Jahr haben wir intensiv iteriert: Tools rund um Intents statt Endpunkte neu gestaltet, Schemas vereinfacht, die Effizienz von Tool-Calls verbessert und Antworten so gestaltet, dass Agenten leichter darüber nachdenken können. Wir investieren außerdem weiterhin tief in die zugrunde liegenden Fundamente – von der Code-Ebene bis zu Filesystem-Abstraktionen –, um zuverlässigere und leistungsfähigere Agenten-Workflows zu unterstützen.
Viele dieser Entscheidungen ähneln inzwischen entstehenden Industriemustern: aufgabenorientierte Tools, agentenlesbare Schemas, umsetzbare Fehleranleitungen und APIs, die um Intent statt um Implementierungsdetails gestaltet sind. Dieser Beitrag teilt die Lektionen, die Webflows MCP-Server geformt haben, und warum das Gestalten für Agenten letztlich viel umfassender wurde, als APIs über MCP zu exponieren. Es erforderte, neu zu durchdenken, wie autonome Systeme Fähigkeiten entdecken, Ausführung koordinieren, Produktoberflächen navigieren und zur Laufzeit zuverlässig arbeiten.
Warum Developer-APIs für Agenten nicht gut funktionieren
Eine Nutzerin könnte einen Agenten bitten, den Hero-Bereich der Startseite zu aktualisieren. In einer traditionellen API kann das zu einer Kette von Low-Level-Operationen werden:
Frühe MCP-Implementierungen exponierten oft bestehende Developer-APIs direkt als MCP-Tools:
MCP selbst war nicht das Problem. Das Protokoll funktionierte wie beabsichtigt. Ein LLM sieht nur Tool-Beschreibungen, Schemas, vorherige Antworten und das aktuelle Context Window. Es muss die Ausführungsstrategie dynamisch ableiten, während es Zwischenzustand über mehrere Tool-Calls hinweg bewahrt. Genau dort beginnen die Fehlermodi aufzutreten. Jeder zusätzliche Tool-Call erhöht Latenz, Token-Verbrauch, Kontextdruck und die Wahrscheinlichkeit eines Ausführungsfehlers. Der Agent muss jetzt:
- Zwischenidentifikatoren korrekt bewahren
- die richtige Ressource aus mehrdeutigen Ergebnissen auswählen
- verrauschte oder zu generische Antworten interpretieren
- abhängige Operationen in der richtigen Reihenfolge koordinieren
- entscheiden, ob Fehler wiederholbar oder endgültig sind
Selbst wenn die API den Workflow technisch unterstützt, fließt zu viel vom Laufzeit-Budget des Modells in die Navigation durch die API, statt in die Erledigung der Aufgabe der Nutzerin.
Was eine Agenten-API braucht
Die Lektion für uns war, dass das Exponieren von APIs über MCP nur der Ausgangspunkt war. Zuverlässige Agenten-Ausführung hing viel stärker von der Form und Semantik der Tools selbst ab. Developer-APIs optimieren typischerweise auf Flexibilität und Komponierbarkeit. Agenten-APIs müssen auf Ausführungszuverlässigkeit optimieren: weniger mehrdeutige Entscheidungen, weniger abhängige Aufrufe, weniger zu bewahrender Zustand und klarere Anleitung, wenn etwas schiefgeht.
Für das Update des Homepage-Hero ist die bessere Schnittstelle ein Tool auf Aufgabenebene, das direkt der Absicht der Nutzerin entspricht:
Deklarative APIs verwandeln komplexe, mehrstufige Workflows in einen einzigen, intent-getriebenen Aufruf. Statt vom Agenten zu verlangen, interne Strukturen zu entdecken, Zwischenzustand zu bewahren, abhängige Operationen zu koordinieren oder sich von Teilfehlern zu erholen, übernimmt die Plattform die Orchestrierung intern. Das reduziert Fehlermodi und lässt den Agenten sich auf das Ziel der Nutzerin konzentrieren statt auf Ausführungsdetails.
Der Wechsel von Low-Level-APIs zu Tools auf Aufgabenebene war richtungsweisend korrekt, führte aber ein neues Problem in Webflows Größenordnung ein: Tool-Explosion. Webflow unterstützt zu viele gültige Workflows, um jeden davon als eigenes MCP-Tool zu modellieren. Ein rein aufgabenorientiertes Design erzeugt schnell eine große, überlappende Tool-Oberfläche, die für Agenten schwer effizient zu navigieren wird. Um dieses Problem zu lösen, gibt es im Grunde 2 Ansätze, und wir besprechen beide Muster in den folgenden Abschnitten genauer:
- Eine geschichtete Tool-Architektur: Statt Hunderte eigenständiger Tools zu exponieren, gruppierten wir verwandte Fähigkeiten in breitere Domänen-Tools mit typisierten, komponierbaren Actions darin. Das gab Agenten eine strukturiertere und besser navigierbare Karte der Produktoberfläche, während der Top-Level-Tool-Raum überschaubar blieb.
- Einführung von Filesystem-Abstraktionen mit Code-Repräsentationen von Webflow-Projekten: Agenten konnten mit einer strukturierten Projekt-Repräsentation über vertraute Programmier- und Shell-Workflows arbeiten. Das verschob einen Teil des Interaktionsmodells von API-Orchestrierung hin zu Ausführungsumgebungen und codegetriebener Manipulation.
Unseren MCP-Server launchen und skalieren
Eine der Lektionen, die wir gelernt haben, war, dass das Gestalten von APIs für Agenten über die API-Oberfläche selbst hinausgeht. Sobald Agenten zu aktiven Teilnehmern in lang laufenden Workflows wurden, begannen viele umgebende Systementscheidungen, die Ausführungsqualität direkt zu beeinflussen: Session-Architektur, Tool-Organisation, Laufzeit-Koordination, Observability und sogar Distribution.
In der Praxis wurde der Bau zuverlässiger Agentensysteme zu einem Full-Stack-Designproblem. Das prägte, wie wir den Webflow-MCP-Server in vier Bereichen angingen:
- Infrastruktur für zustandsbehaftete Ausführung und Laufzeit-Koordination
- Tool-Oberflächen-Design für Klarheit und effiziente Fähigkeiten-Entdeckung
- Observability-Systeme, um echtes Agentenverhalten zu verstehen
- Distributionsmuster, die Setup-Reibung reduzierten und Adoption skalierten
1. Infrastruktur
Die Infrastrukturanforderungen für einen MCP-Server erwiesen sich als sehr unterschiedlich von einem traditionellen API-Service. Während MCP selbst keinen serverseitigen Zustand erfordert, sind reale Agenten-Workflows stark zustandsbehaftet. Ein Agent kann sich einmal authentifizieren, den Site-Kontext prüfen, mehrere Tools über verschiedene Produktoberflächen hinweg aufrufen und in einem lang laufenden Workflow weiterhin nachdenken. Jede Interaktion als vollständig zustandslos zu behandeln, würde das Modell zwingen, Kontext und Ausführungszustand wiederholt zu rekonstruieren, was sowohl Latenz als auch Fehlerwahrscheinlichkeit erhöht.
Wir haben den Webflow-MCP-Server auf Cloudflare mit Durable Objects gebaut, weil sie ein natürliches, session-orientiertes Ausführungsmodell bieten. Jede MCP-Session besitzt ihre eigene Server-Instanz, die Nutzerkontext, verfügbare Tools und Laufzeit-Koordination verwaltet, ohne separate Session-Infrastruktur zu benötigen.
Wir mussten außerdem zwei unterschiedliche Ausführungsumgebungen unterstützen. Manche Operationen laufen headless über Webflow-APIs, während Designer-Aktionen, wie das Einfügen von Elementen oder das Aktualisieren von Stilen, von der Live-Browser-Arbeitsfläche abhängen. Für diese Workflows unterhält der MCP-Server eine WebSocket-Brücke zu einer Designer Extension, die innerhalb der aktiven Webflow-Session der Nutzerin läuft.
Diese Architektur gibt Agenten eine einheitliche MCP-Oberfläche, während das System Operationen im Hintergrund an die richtige Laufzeitumgebung weiterleitet. Gleichzeitig verschieben wir zunehmend mehr Designer-Fähigkeiten in Headless-APIs. Die Abhängigkeit von Live-Browser-Ausführung zu reduzieren, vereinfacht die Laufzeit-Architektur, senkt die Koordinationskomplexität und verbessert die allgemeine Stabilität und Zuverlässigkeit für Agenten-Workflows.
2. Die Tool-Oberfläche gestalten
Wie bereits erwähnt, haben wir zwei unterschiedliche Ansätze gefunden, die helfen, Orchestrierungs- und Entdeckungs-Overhead für Agenten zu reduzieren: geschichtete Tool-Organisation und Filesystem-Abstraktionen mit Code-Repräsentationen von Webflow-Projekten. Mit der Zeit begannen wir, diese als kurzfristige und langfristige Lösungen für dasselbe zugrunde liegende Problem zu betrachten.
Kurzfristig hilft die geschichtete Tool-Architektur, während die MCP-Oberfläche wächst, da wir Agenten eine bessere Karte geben, statt alle Tools gleichzeitig zu exponieren. Statt jede Aufgabe als eigenständiges MCP-Tool zu exponieren, gruppierten wir verwandte Fähigkeiten in Domänen-Tools mit typisierten, komponierbaren Actions darin. So sind zum Beispiel CMS-Operationen unter einer gemeinsamen Tool-Oberfläche für Collections, Felder, Items, Publishing und Updates gruppiert, während Designer-Fähigkeiten um Elemente, Stile, Variablen, Assets und Komponenten organisiert sind.
Genauer gesagt entwickelte sich die Tool-Oberfläche zu mehreren Schichten:
- Domain-Tools organisieren breite Produktbereiche
- Actions bieten komponierbare, typisierte Primitives innerhalb jeder Domäne
- Workflow-Tools kapseln orchestrierungsintensive Aufgaben
- Guide-Tools liefern operative Anleitungen und Produktkontext für sicherere Ausführung
Obwohl dieser Ansatz definitiv half, Probleme mit Tool-Oberfläche und Orchestrierung zu mildern, beseitigt er das Problem nicht grundlegend. Wenn Produktfähigkeiten wachsen, kann die Zahl gültiger Workflows und Actions weiterhin schnell zunehmen, selbst innerhalb einer geschichteten Architektur. An einem gewissen Punkt verschiebt sich die Herausforderung davon, Tools einfach zu organisieren, hin dazu, die Abhängigkeit des Systems von expliziter Tool-Entdeckung insgesamt zu reduzieren. Selbst gut strukturierte Tool-Hierarchien erfordern noch, dass das Modell sucht, Fähigkeiten auswählt, Schemas interpretiert und die Ausführung über APIs hinweg koordiniert.
Genau hier werden Filesystem-artige Abstraktionen und codeorientierte Umgebungen immer wichtiger. Statt jede Interaktion durch explizite MCP-Tool-Aufrufe zu zwingen, können Agenten mit einer strukturierten Projekt-Repräsentation arbeiten, eher wie ein programmierbarer Arbeitsbereich. Anthropic und Cloudflare haben beide ähnliche Richtungen in jüngster Agenten-Infrastruktur-Arbeit besprochen. Siehe das folgende Beispiel für die Homepage-Update-Aufgabe im Code-Modus:
Das spielt viel natürlicher mit den aktuellen Stärken von LLMs. Modelle sind bereits sehr effektiv im Nachdenken über strukturierten Text, im Generieren von Code, im Bearbeiten von Dateien und im Arbeiten innerhalb von Ausführungsumgebungen. Indem das Interaktionsmodell von API-Orchestrierung zu strukturierter Zustandsmanipulation verschoben wird, reduziert das System Entdeckungs-Overhead, Kontextverbrauch und die Last mehrstufiger Koordination.
Die tiefere Lektion ist, dass das Skalieren von Agentensystemen nicht nur darum geht, mehr Tools hinzuzufügen. Es geht darum, Modellen eine besser navigierbare und effizientere Betriebsumgebung zu geben.
3. Observability
Observability wurde viel wichtiger, sobald Agenten begannen, autonom über lang laufende Workflows hinweg zu arbeiten.
Traditionelle Logs und Traces waren nützlich fürs Infrastruktur-Debugging – sie konnten uns sagen, welche Requests fehlschlugen, Latenzmuster oder serverseitige Exceptions. Aber sie waren schlecht geeignet, um Agentenverhalten zu verstehen. Sie sagten uns nicht, was der Agent tatsächlich zu erreichen versuchte, welche Fähigkeiten er erwartete, wo Workflows verwirrend wurden oder warum scheinbar „erfolgreiche" Sessions trotzdem schlechte Ergebnisse produzierten.
Um diese Lücke zu schließen, integrierten wir MCPCat als Observability-Schicht rund um den MCP-Server selbst. Indem der Server bei der Initialisierung umschlossen wird, erfasst es Tool-Calls, Ressourcen-Lesevorgänge, Versuche mit fehlenden Tools, Session-Metadaten und Antwortmuster über den gesamten Ausführungsfluss hinweg. Das wertvollste Signal erwies sich als Intent.

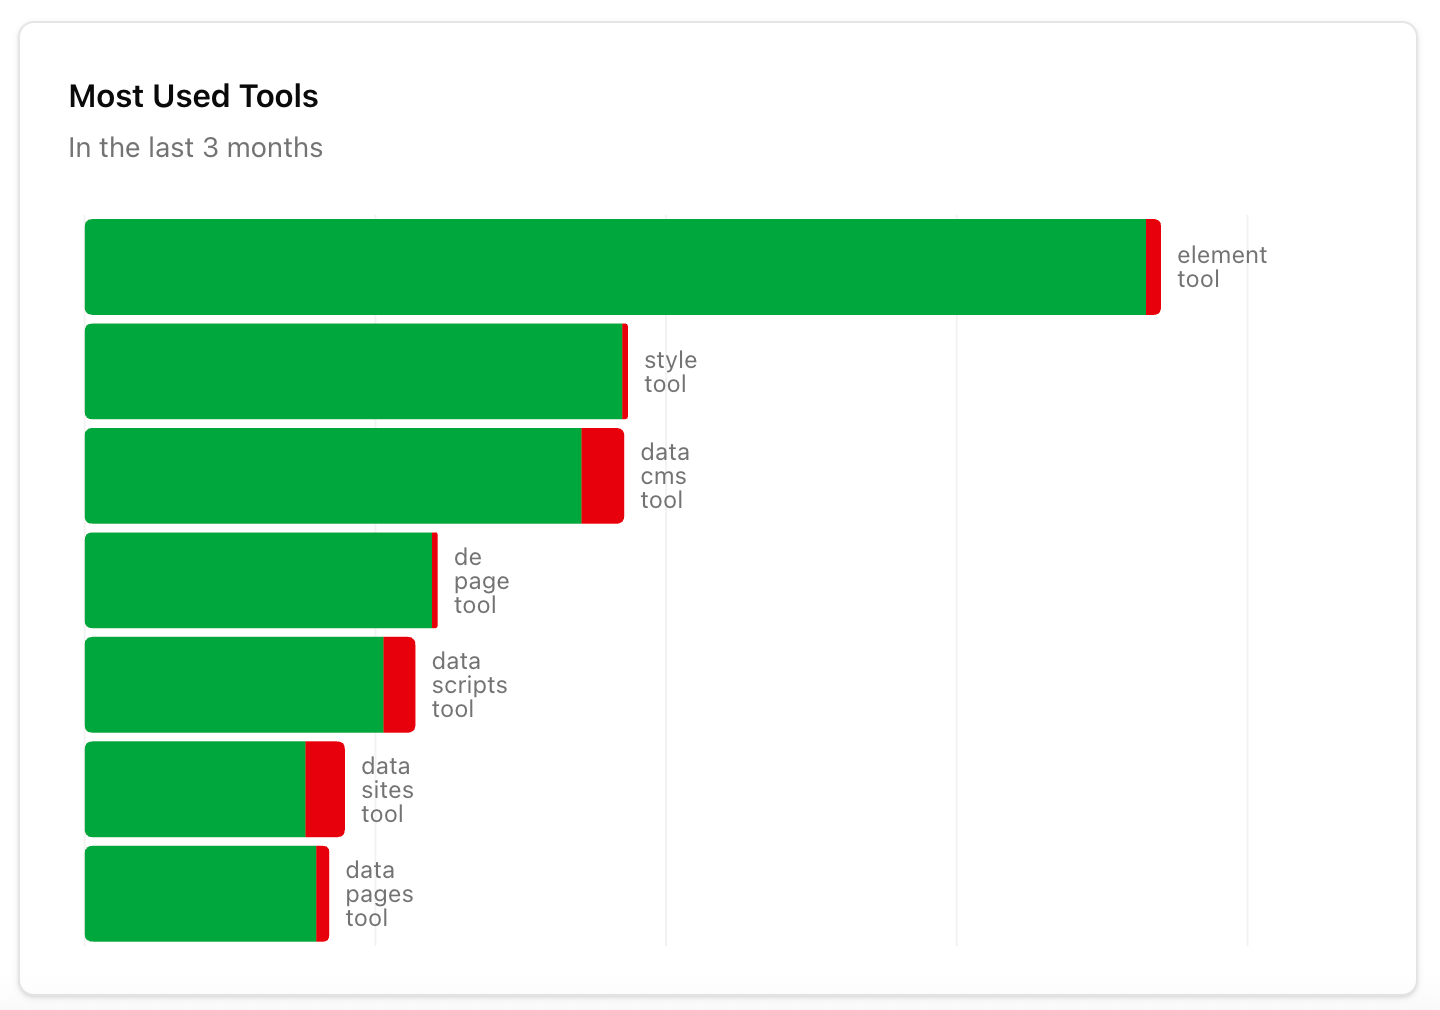
Versuche mit fehlenden Tools legten Fähigkeiten oder Namensmuster offen, die Agenten erwarteten, aber nicht finden konnten. Session-Replay legte degradierte Workflows offen, bei denen das Modell wiederholt explorierte, wiederholte oder die Richtung wechselte, ohne je einen harten Fehler zu produzieren. In vielen Fällen erschien das System aus Infrastruktursicht gesund, während die Agenten-Erfahrung dennoch still scheiterte.
Wir erwarteten zunächst, dass CMS-Migration und Content-Management die Nutzung dominieren würden. Stattdessen zeigten Agent Goals, dass das direkte Gestalten in der Webflow-Arbeitsfläche über Drittanbieter-Agenten 27,7 % der Sessions ausmachte. Wir entdeckten außerdem einen stillen Fehler, der mehr als 10 % der Sessions betraf, und fanden heraus, dass sich 58,7 % der Sessions um drei Kern-Workflows gruppierten.
Mit der Zeit erkannten wir, dass Observability für Agentensysteme grundlegend anders ist als Observability für APIs. Das Ziel ist nicht nur zu verstehen, ob Requests erfolgreich waren, sondern zu verstehen, wie Modelle nachdenken, Fähigkeiten erkunden, sich von Mehrdeutigkeit erholen und während der Ausführung scheitern.
4. Distribution skalieren
Distribution für einen MCP-Server zu skalieren ging nicht nur darum, mehr Traffic zu bewältigen. Es ging darum, Adoptionsreibung zu reduzieren, zu erweitern, wo Agenten Webflow nutzen konnten, und die Qualität der Workflows zu verbessern, die diese Agenten ausführen konnten.
Die Adoption beschleunigte sich, nachdem wir Anfang 2026 einen gehosteten MCP-Connector eingeführt haben, beginnend mit Claude, was die Setup-Reibung für Nutzer:innen deutlich reduzierte. Statt MCP-Verbindungen und Authentifizierungs-Flows manuell zu konfigurieren, konnten sich Nutzer:innen über eine gemanagte, gehostete Integration mit deutlich weniger operativem Overhead mit Webflow verbinden. Wir haben in den letzten 3 Monaten ein 6,7-faches Session-Wachstum beobachtet.
Die Skalierung der Adoption machte außerdem eines klar: Agenten brauchen mehr als Tools. Tools legen frei, was ein Agent tun kann; Skills kodieren, wie man es gut macht. Bei Webflow erfordern viele erfolgreiche Ergebnisse Produkturteilsvermögen, wiederverwendbare Workflows und Domänenkonventionen – nicht nur API-Zugriff. Mehr nützliche Skills in die Webflow-MCP-Erfahrung zu bringen, etwa Layout-Muster, CMS-Migrations-Playbooks, SEO-Workflows, Barrierefreiheits-Checks und Brand-System-Anleitung, wird entscheidend, während Agenten von einfachen Tool-Calls zu End-to-End-Site-Arbeit übergehen.
Mit steigender Adoption verschoben sich die Herausforderungen von Protokollmechanik zu Produkterfahrung für autonome Systeme: reicheren Site-Kontext liefern, die Skill-Schicht erweitern und verstehen, ob Agenten-Aktionen Nutzer:innen tatsächlich halfen, bedeutungsvolle Ergebnisse zu erzielen.
Zusammenfassung
Agenten sind nicht nur ein weiterer API-Client. Sie sind eine andere Art von Laufzeit-Teilnehmer: einer, der durch Kontext nachdenkt, Fähigkeiten dynamisch erkundet, aus der Interface-Struktur lernt und darauf angewiesen ist, dass das System die nächste korrekte Aktion auffindbar und zuverlässig macht.
Für diese Art von Nutzer zu gestalten verändert viel mehr als nur APIs. Es beeinflusst, wie wir Tools strukturieren, Orchestrierung managen, Kontext freilegen, Ausführungsumgebungen bauen, Workflows beobachten und sogar wie Produktoberflächen selbst modelliert werden. Mit der Zeit fanden wir uns selbst dabei, nicht nur MCP-Schnittstellen zu gestalten, sondern vollständige Betriebsumgebungen für autonome Systeme.
Das trieb uns hin zu geschichteten Tool-Architekturen, Workflow-Abstraktionen, Filesystem-artigen Projekt-Repräsentationen, reicherer Observability und Skill-Schichten. Das Ziel war nie, einfach mehr Fähigkeiten für Agenten zu exponieren. Es ging darum, Modellen zu helfen, korrekte Entscheidungen mit weniger Exploration, weniger Orchestrierungslast und größerer Ausführungszuverlässigkeit zu treffen.
Die Arbeit, die vor uns liegt, besteht nicht nur darin, Webflow für Agenten programmierbar zu machen. Es geht darum, Webflow für autonome Systeme lesbar, navigierbar und operativ zuverlässig zu machen, ohne die Flexibilität zu verlieren, die die Plattform für Menschen so leistungsfähig macht. Das ist sowohl eine tiefe Produktherausforderung als auch eine Systemherausforderung – und genau die Art von Problem, die wir bei Webflow mit Begeisterung lösen.