



Einblick in Webflows MCP-Eval-Harness
Ein grüner Haken in Ihrem Agenten sagt Ihnen nicht, dass der Agent das Richtige mit Ihren Tools tun wird. Er sagt Ihnen, dass die Tools gültiges JSON zurückgegeben haben. Das sind unterschiedliche Aussagen, und in der Lücke dazwischen scheitern MCP-Server tatsächlich vor einem echten Nutzer, mit einem echten Agenten, der seine eigenen Entscheidungen trifft. Und manchmal sind diese Entscheidungen ziemlich schlecht, wenn Kunden darauf vertrauen, dass ihre Markenerfahrung von einem Produkt getragen wird. In diesem Beitrag sprechen wir darüber, wie wir mehr Vertrauen in das Verhalten unseres MCP-Servers in Agenten aufbauen, die wir nicht kontrollieren.
Das Problem beim Testen eines MCP-Servers
Webflows Model-Context-Protocol-Server (MCP) übergibt KI-Agenten, ob Claude, ChatGPT, Cursor oder was eine Person sonst verbindet, eine Reihe von Tools zum Bauen von Seiten, Verwalten von CMS-Inhalten und Veröffentlichen von Websites im Auftrag einer Person. Traditionelle Tests können feststellen, dass jedes MCP-Tool isoliert betrachtet korrekt ist: Es akzeptiert die richtigen Eingaben, erzwingt Berechtigungen, verändert den erwarteten Zustand und behandelt Fehler ordnungsgemäß. Aber sie können eine andere Frage nicht beantworten: Wird ein autonomer Agent, der die gesamte Tool-Oberfläche sieht und eine Aufgabe in Alltagssprache erhält, diese Fähigkeiten korrekt entdecken und kombinieren?
Eine Antwort erhält man nur, indem man beobachtet, wie sich ein Agent verhält. Genau das tut unser Eval-Harness. Er steuert echte Agenten-Hosts headless gegen echte, wegwerfbare Webflow-Websites, mit Aufgaben in Alltagssprache. Er bewertet, was der Agent zu tun beschließt, nicht nur, ob die von ihm aufgerufenen Tools gültige Antworten zurückgegeben haben.
Was er tatsächlich tut
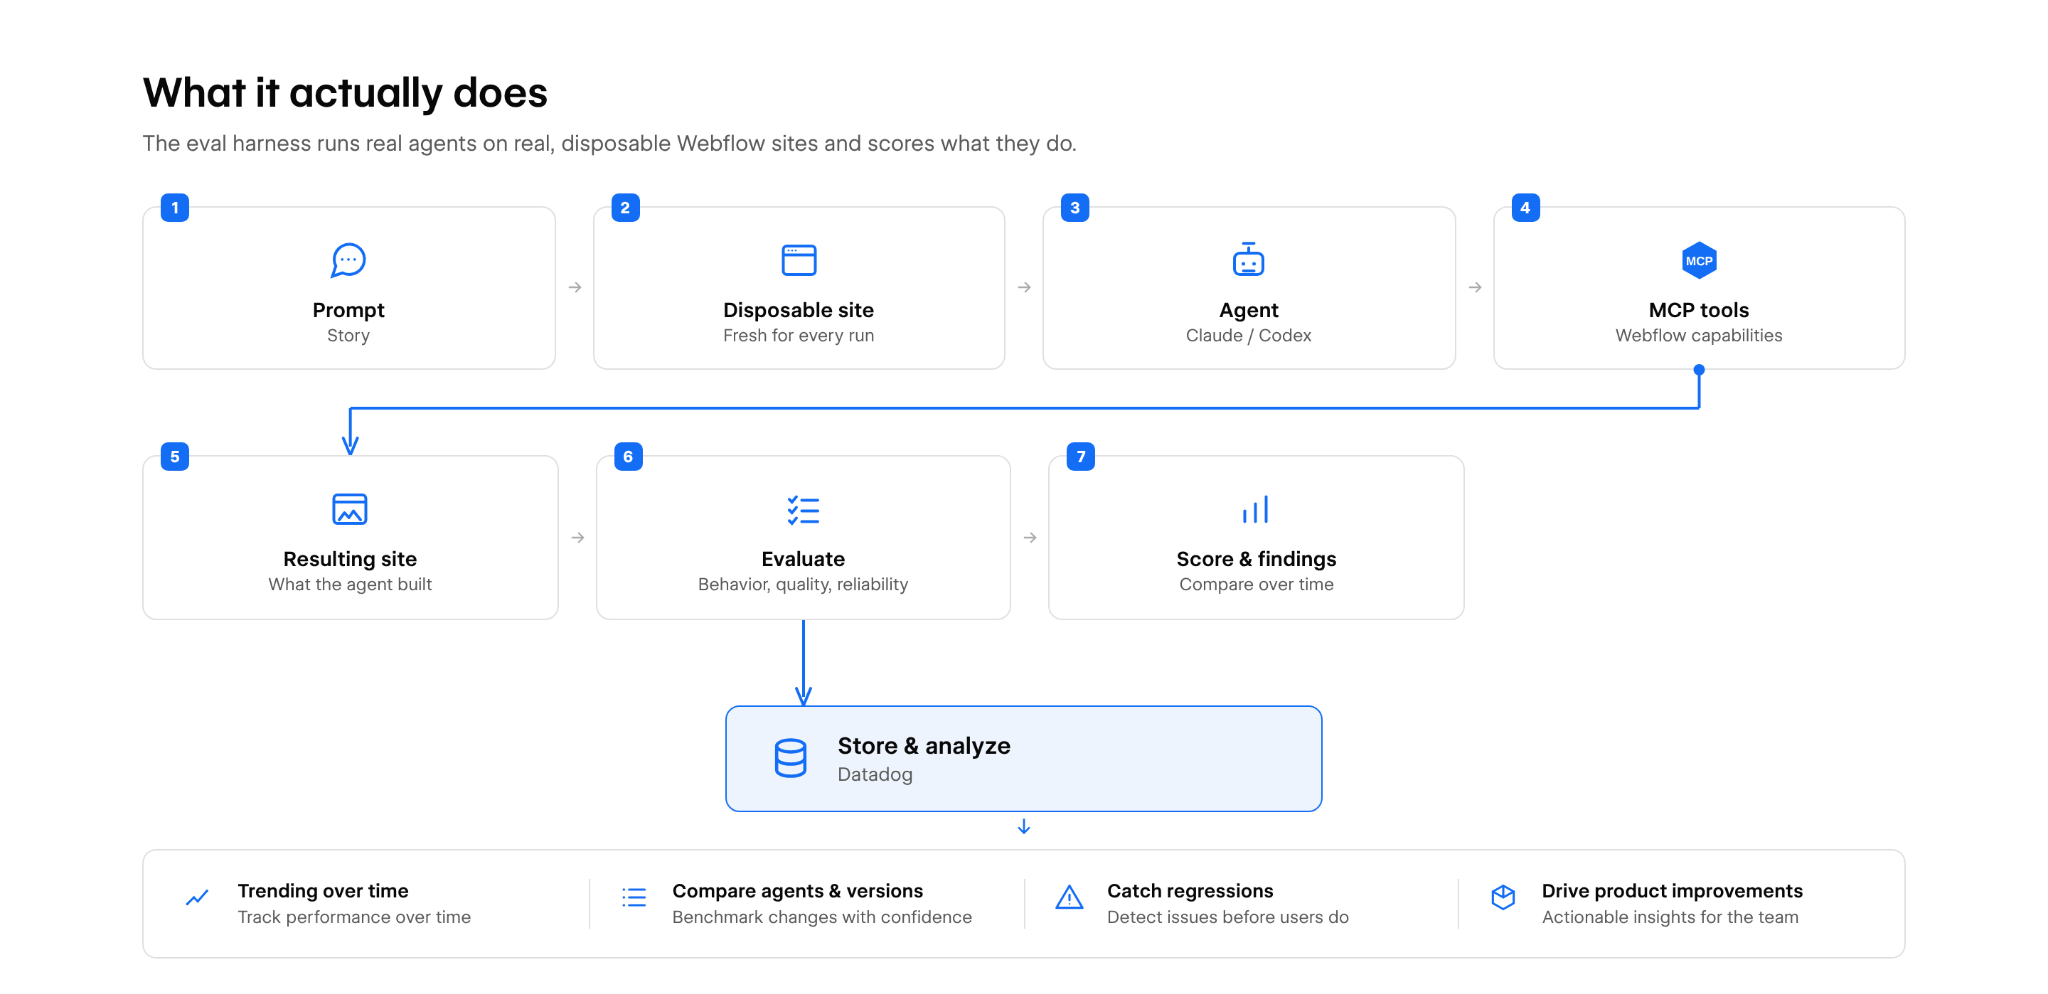
Der Harness führt Stories aus: mehrstufige agentische Aufgaben, geschrieben als einfache Prompts, jede mit Assertions darüber, was passieren sollte. Eine Story könnte sein: „Erstelle eine CMS-Collection mit drei Feldern und einem Eintrag“, oder „Baue eine vollständige SaaS-Landingpage headless und veröffentliche sie.“
Für jede Story stellt der Harness eine frische Website bereit und lässt einen echten Agenten Zug um Zug dagegen laufen, derzeit Claude Code oder OpenAIs Codex CLI. Deterministische Prüfungen verifizieren erwartete und verbotene Tool-Nutzung und, wo relevant, ob ein behaupteter Schreibvorgang tatsächlich stattfand. Ein LLM-Judge liest das Transkript und die finale Antwort auf Aufgabenerfüllung, Tool-Auswahl und Korrektheit. Seitenbau-Stories fügen einen visuellen Judge über das gerenderte Ergebnis hinzu, während strukturelle Signale prüfen können, was der Screenshot nicht zeigt.
Jeder Trace, Score, Finding und Screenshot geht an Datadog, sodass Läufe abfragbar und über die Zeit vergleichbar sind. Das ist das Grundgerüst. Der interessante Teil ist, was wir gelernt haben, sobald eine einzelne Bestanden/Nicht-bestanden-Zahl nicht mehr ausreichte.
Hat der Agent tatsächlich das Richtige getan?
Wir trennen die Korrektheit des Ergebnisses von der Diagnose des Ausführungswegs. Erstens: Ist die beabsichtigte Zustandsänderung tatsächlich eingetreten? Zweitens: Hat der Agent eine echte Einschränkung verletzt, etwa ein destruktives Tool oder eine in diesem Host nicht verfügbare Fähigkeit genutzt? Schließlich: Hat er einen unerwartet schwierigen Weg genommen, der darauf hindeutet, dass die Tool-Oberfläche klarer sein könnte? Ein anderer Weg ist nicht unbedingt falsch, aber es lohnt sich oft, ihn zu verstehen.
Jeder Lauf hinterlässt eine Mängelliste, nicht nur einen Score
Derselbe LLM-Judge-Aufruf, der eine Story bewertet, erzeugt auch Findings: konkrete, umsetzbare Probleme, die im Transkript aufgefallen sind, unabhängig davon, ob die Story bestanden hat. Ein Tool-Aufruf schlug fehl. Der Agent hat eine verwirrende Fähigkeit umgangen. Eine fehlende Fähigkeit musste vorgetäuscht werden. Eine Story kann jede Assertion bestehen und trotzdem Findings zutage bringen, denn „der Agent kam am Ende dort an“ und „die Tools haben das leicht gemacht“ sind unterschiedliche Fragen.
Ein paar Findings direkt aus echten Läufen:
- data_whtml_builder lehnt mehrere Root-Elemente pro Aufruf ab, was den Agenten zwingt, drei Abschnitte in separate Einfügungen aufzuteilen und sie in umgekehrter Reihenfolge einzufügen; das Tool sollte Multi-Root-Fragmente unterstützen.
- data_style_tool liefert Antworten über 71 KB, die Token-Limits überschreiten, was den Agenten zwingt, zum Parsen auf Bash auszuweichen.
- Webflow benennt CSS-Klassen bei Kollisionen automatisch um (.hero wird zu .hero-1-2-3), was den vom Agenten beabsichtigten Klassennamen stillschweigend zerstört, ohne Warnung vom Tool.
Keiner davon ist ein Bestanden/Nicht-bestanden-Bug. Jede Story wurde trotzdem abgeschlossen. Aber jedes ist konkretes Produkt-Feedback, das ein Agent durch tatsächliches Erleben des Papercuts zutage brachte, nicht durch jemanden, der rät, was schiefgehen könnte. Diese Findings leben im Trace neben dem Score, sodass ein grüner Haken den Weg, den der Agent nehmen musste, nicht mehr verwischt.
Was verbirgt ein einzelner Lauf?
Ein einzelner erfolgreicher Lauf kann bedeutsame Varianz verbergen, deshalb kann der Harness dieselbe Story wiederholt ausführen, jedes Mal mit einer frischen Website und Agenten-Session. Das ist zunächst ein Diagnosewerkzeug, kein Anspruch auf statistische Zuverlässigkeit. In einer frühen Drei-Läufe-Diagnose bestanden die deterministischen Assertions in allen drei Läufen, während die Design-Qualitäts-Scores 40 %, 80 % und 85 % betrugen. Drei Beobachtungen reichen nicht aus, um die zugrunde liegende Erfolgsverteilung zu schätzen, aber sie offenbarten sofort etwas, das die ursprüngliche Zusammenfassung verschleiert hatte: Die Tool-Ausführung war stabil, die Ausgabequalität nicht.
Die ursprüngliche Konsolen-Zusammenfassung meldete mean=1.00 und stdev=0.00, weil die Aggregation nur den deterministischen Score sah. Dieses Ergebnis war mathematisch korrekt und operativ irreführend. Wir berichten diese Dimensionen jetzt getrennt und bewahren die rohen Lauf-Ergebnisse: deterministische Prüfungen bestanden mit 1.00 in allen drei Läufen; die Design-Qualität erzielte 40 %, 80 % und 85 %. Mit wachsenden Stichprobengrößen kann dieselbe Infrastruktur belastbarere Zuverlässigkeits- und Regressionsanalysen unterstützen.
Das offensichtliche Signal ist nicht das einzige Signal
Ein LLM-Judge, der einen Screenshot bewertet, sieht nur den Screenshot. Zwei Seiten können pixelidentisch rendern, während die eine aus sinnvoller Struktur aufgebaut ist (<nav>, <section>, <button>) und die andere durchgehend Div-Suppe ist. Das ist ein echter Unterschied bei Barrierefreiheit und Wartbarkeit, und er ist für ein Bild unsichtbar.
Wir haben semantic_html_ratio hinzugefügt, ein deterministisches Signal ohne LLM, berechnet aus dem gerenderten HTML, das bereits für den Screenshot erfasst wurde: der Anteil semantischer Tags gegenüber generischen Wrappern, über Seiten hinweg nach Markup-Volumen kombiniert statt naiv gemittelt. Es ist kein Bestanden/Nicht-bestanden-Gate. Wrapper-Divs sind normal, und Webflows eigener visueller Builder ist naturgemäß div-schwer, aber es gibt uns ein zweites, unabhängiges Signal zum Vergleichen von Läufen und Beobachten von Trends über die Zeit.
Agenten-Host-Abdeckung ist Teil der Eval-Abdeckung
Das ist der Punkt, der in der Praxis am meisten zählte. OpenAI lehnte eine unserer ChatGPT-App-Einreichungen ab, nachdem ein Agent versucht hatte, ein Designer-Canvas-Tool zu nutzen, das einen offenen Webflow-Designer-Tab erfordert, etwas, das eine ChatGPT-Session niemals haben kann. Wir haben die exakt abgelehnten Prompts wiederholt durch unseren Harness laufen lassen und den Fehler nie reproduziert. Kein einziges Mal.
Der Grund war unangenehm einfach: Der Harness war bis dahin ausschließlich von Claude gesteuert worden, und Claude ging im Grunde nie auf diesen Köder der statischen Tool-Anleitung ein. Die Ablehnung in Produktion kam von einem Modell der GPT-Familie. Wir hatten einen echten Eval-Harness gebaut und ihn nie gegen den Agenten laufen lassen, der tatsächlich in Produktion scheiterte.
Also fügten wir einen zweiten Treiber hinzu, der auf OpenAIs Codex CLI zugreift, genauso wie der ursprüngliche auf Claude Code zugreift. Beide teilen sich einen Orchestrierungskern: Provisioning, Scoring, Judges, Screenshots, Retries und Upload sind identisch. Nur „den Agenten starten und seine Ausgabe parsen“ unterscheidet sich.
Dann führten wir einen kontrollierten Vergleich durch: der ursprüngliche Prompt gegen einen mit einer expliziten Anweisung „keine Designer-Canvas-Tools verwenden“ verstärkten, jeweils fünf unabhängige Wiederholungen, auf beiden Treibern.
Dieselbe Aufgabe und derselbe MCP-Server erzeugten materiell unterschiedliches Verhalten bei Claude Code und Codex CLI. Dieses Experiment isoliert das zugrunde liegende Modell nicht von der umgebenden Host-Orchestrierung, und operativ muss es das auch nicht. Nutzende erleben das Gesamtsystem: Modell, Systemanweisungen, Tool-Darstellung, Kontextverwaltung und Ausführungsrichtlinie. Die Lektion war nicht, dass ein Modell besser war. Sie war, dass die Validierung gegen einen einzigen Agenten-Host uns ein Vertrauen gab, das sich nicht auf eine andere Umgebung übertrug. Jede oben genannte vertrauensbildende Funktion, einschließlich Wiederholungstests, semantischer Signale und Transkript-Beurteilung, läuft jetzt identisch gegen beide Hosts, weil diese Fähigkeiten im gemeinsamen Kern liegen statt in Claude-spezifischem Code. Was wir künftig prüfen, prüfen wir auf beiden.
Warum das für die Zukunft wichtig ist
Einem grünen Haken nachzujagen war nie der Punkt. Bevor wir ausliefern, können wir etwas Konkretes und Wahres sagen: Wir haben genau diese Aufgabe mehrfach gegen mehrere echte Agenten laufen lassen, und hier ist, was tatsächlich passiert ist. Das ist eine andere Art von Vertrauen als bestandene Tests.
- Jede Änderung am Tool-Schema läuft vor der Auslieferung durch die Story-Suite. Dieselben Stories können auf einen lokal laufenden MCP-Server zeigen, sodass Regressionen bei einem Pull Request erkannt werden können, statt erst nach dem Deploy.
- Jede erneute Einreichung einer ChatGPT-App wird zuerst gegen beide Treiber geprüft, sodass ein Fix gegen die Modellfamilie geprüft wird, die tatsächlich versagt hat, nicht nur gegen die, die zufällig bestanden hat.
- Eine unzuverlässige Story zeigt sich als unzuverlässig, mit Varianz, statt in der CI Glück zu haben und später jemanden zu überraschen.
Die Suite läuft jetzt nächtlich und verwandelt Drift in eine Zahl, die sich täglich bewegt, statt in eine Produktionsbeschwerde, die jemand Wochen später zurückverfolgen muss.
Die nächtliche Suite gibt uns kontinuierliche Abdeckung, aber der Harness ist im Tagesgeschäft von Produkt und Engineering genauso nützlich. Eine Person, die ein Tool ändert, oder jemand im Produktteam, der eine neue Fähigkeit validiert, kann manuell genau die Stories und die Agenten-Abdeckung ausführen, die ihr wichtig sind, bevor irgendetwas ausgeliefert wird.
Wir haben das operative Wissen in einen Claude-Code-Skill verwandelt, /eval-harness-runbook. Jemand kann beschreiben, was getestet werden soll, und der Skill übernimmt Setup, relevante Abdeckung, Experiment-Benennung und Findings nach dem Lauf. Das macht den Harness zu einer Self-Service-Testfläche für Engineering und Produkt.
Es auszuführen ist vom Kennen der richtigen Formel zum Fragen geworden, und man erhält eine Antwort.
Wohin es sich entwickelt
Die kurzfristige Arbeit ist operativ: Tools ohne Story-Abdeckung automatisch markieren und jeden nächtlichen Lauf in einen Bericht über Regressionen, neue Findings und nennenswerte Varianz verwandeln, der dort landet, wo Menschen bereits hinschauen.
Die schwierigere Frage ist, was ein Score eigentlich bedeutet. Heute stammt jedes Story-Briefing, einschließlich dessen, was als „gut“ zählt, von wer es auch geschrieben hat. Nützlich, aber erfunden. Wir wollen eine Gold-Referenz-Obergrenze: eine ideale Version einer Flaggschiff-Story von Hand bauen, sie durch denselben Judge bewerten und künftige Läufe relativ zu dieser Obergrenze ausdrücken, statt einen nackten 0-bis-4-Score als selbsterklärend zu behandeln.
Und das Story-Set selbst sollte nicht beim Launch einfrieren. Derzeit spiegelt es wider, was wir uns als mögliche Nutzerfragen vorgestellt haben. Mit der Zeit wollen wir neue Stories, die auf echten Nutzungsmustern und Analytics beruhen, nicht auf Rohdaten von Nutzenden, sodass das, was in der Welt tatsächlich passiert, der Suite beibringt, was als Nächstes zu testen ist. Das ist die Version dieses Harness, auf die es sich zu bauen lohnt: nicht nur zu erfassen, was wir zu prüfen für richtig hielten, sondern zu lernen, was wir nicht bedacht hatten.